

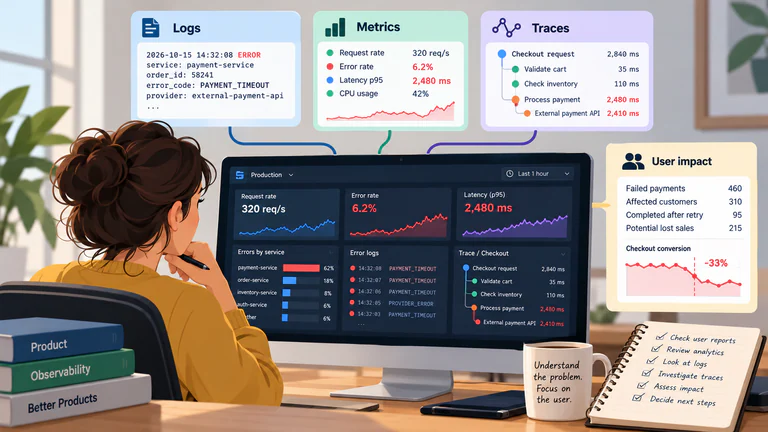
Un cliente informa que no puede completar un pago. El soporte ha recibido varias quejas similares, pero el panel del producto muestra que la conversión de pago es, en general, estable. Ingeniería ha comenzado a investigar, aunque el problema es difícil de reproducir y nadie está seguro de cuántos usuarios están afectados.
En este incidente hipotético, Soporte, Producto e Ingeniería tienen partes distintas de la evidencia. Los informes describen la experiencia, la analítica sitúa los cambios de comportamiento y las señales técnicas registran las operaciones implicadas. La investigación necesita relacionarlas para estimar el impacto.
La observabilidad del producto se refiere a la capacidad de comprender cómo se comporta un producto en producción, incluidas las condiciones técnicas que afectan los viajes de los usuarios. Se basa en información de registros de aplicaciones, métricas de rendimiento, seguimientos distribuidos, análisis de productos y otros sistemas de monitoreo.
Durante la evaluación del incidente, esas relaciones permiten identificar a los clientes afectados, las alternativas disponibles y la urgencia de la corrección. Una API puede devolver respuestas satisfactorias mientras los clientes siguen sin poder completar el recorrido.
1. ¿Qué es la observabilidad del producto?
La observabilidad es un concepto utilizado en ingeniería de software para describir qué tan bien se puede entender el comportamiento interno de un sistema a partir de la información que produce. En la práctica, esta información puede incluir registros, métricas, seguimientos y otras señales de diagnóstico recopiladas mientras se ejecuta la aplicación.
La observabilidad del producto aplica estas capacidades a preguntas sobre el comportamiento del producto y la experiencia del usuario. Conecta la evidencia técnica con los recorridos y resultados que los Product Managers son responsables de evaluar. Una aplicación puede informar que sus servidores están en buen estado y sus endpoints API están respondiendo correctamente. Esos indicadores son útiles, pero es posible que no revelen que un grupo particular de clientes no puede completar el registro debido a un problema con un servicio externo de verificación de identidad.
El problema se vuelve visible cuando se examina la información técnica junto con el recorrido del usuario afectado. Las solicitudes de autenticación pueden tener éxito, mientras que las solicitudes de verificación fallan para los clientes de un país en particular. Los análisis de productos pueden mostrar un aumento en el abandono en el paso de verificación y es posible que el soporte esté recibiendo quejas del mismo segmento de clientes.
Juntas, estas señales proporcionan una imagen más clara del incidente que la que cualquier fuente podría ofrecer de forma independiente.
Monitoreo y observabilidad
El monitoreo y la observabilidad están estrechamente relacionados, aunque enfatizan actividades diferentes. El monitoreo generalmente implica rastrear indicadores conocidos y verificar si permanecen dentro de los límites esperados. Un equipo puede monitorear los tiempos de respuesta de la API, el consumo de recursos del servidor o el porcentaje de transacciones fallidas.
La observabilidad proporciona la información y las capacidades de investigación necesarias para comprender el comportamiento del sistema, incluidos los problemas que no se anticiparon cuando se establecieron las reglas de monitoreo. Por ejemplo, una alerta podría notificar a Ingeniería que los errores de pago han superado un umbral aceptable. La supervisión detecta el cambio, mientras que las herramientas de observabilidad ayudan a investigar qué servicios, solicitudes o dependencias contribuyeron al mismo.
La distinción es útil cuando se analizan los requisitos operativos. Un equipo de producto puede necesitar alertas para condiciones de falla conocidas y al mismo tiempo requerir suficiente información de diagnóstico para investigar comportamientos inesperados.
2. Las tres señales principales: registros, métricas y seguimientos
Los sistemas de software producen diferentes tipos de información operativa. Los registros, las métricas y los seguimientos distribuidos se suelen utilizar juntos porque cada uno proporciona una perspectiva diferente sobre el comportamiento de la aplicación.
Registros: ¿Qué pasó?
Los registros son registros de eventos generados por aplicaciones e infraestructura. Pueden describir operaciones exitosas, fallas de validación, intentos de autenticación, excepciones o interacciones con servicios externos. Una aplicación de comercio electrónico podría generar una entrada de registro como:
2026-10-15 14:32:08 ERROR
service: payment-service
order_id: 58241
error_code: PAYMENT_TIMEOUT
provider: external-payment-api
Esta entrada indica que una operación de pago encontró un tiempo de espera mientras se comunicaba con un proveedor externo. Una sola entrada de registro no establece el alcance del problema, pero proporciona detalles que pueden ayudar a Ingeniería a investigar. La búsqueda del mismo código de error durante un período definido puede revelar si el problema ocurrió una vez o afectó a cientos de transacciones.
Los registros son particularmente útiles al investigar fallas específicas, especialmente cuando contienen identificadores consistentes que permiten conectar eventos relacionados. Se pueden utilizar herramientas como Kibana para buscar y analizar registros almacenados en Elasticsearch. Los equipos de ingeniería pueden usarlos para identificar errores recurrentes, inspeccionar solicitudes individuales y examinar cambios en el comportamiento de las aplicaciones.
Métricas: ¿Con qué frecuencia y cuánto?
Las métricas son medidas numéricas recopiladas a lo largo del tiempo. Describen propiedades como el volumen de solicitudes, el tiempo de respuesta, las tasas de error, el uso de recursos y la disponibilidad del servicio. Por ejemplo, un servicio de pago podría informar que su tasa de error aumentó del 0,4% al 6,2% durante un período de quince minutos.
Ese cambio indica un deterioro en el rendimiento, aunque se necesita más investigación para comprender la causa. Las métricas son particularmente útiles para identificar tendencias y comparar comportamientos entre períodos. Pueden revelar si un problema está generalizado, si comenzó después de una implementación o si el rendimiento se está deteriorando gradualmente.
La selección de métricas es importante. El tiempo de respuesta promedio puede permanecer estable incluso cuando una pequeña proporción de usuarios experimenta solicitudes muy lentas. Las mediciones de percentiles, como el percentil 95 o 99, pueden proporcionar información adicional sobre el extremo más lento de la distribución del tiempo de respuesta.
Para los Product Managers, las métricas técnicas se vuelven más útiles cuando se conectan con las operaciones que los clientes intentan completar. Un aumento en la latencia de API puede ser relativamente inofensivo para un proceso de sincronización en segundo plano, pero particularmente perjudicial durante el pago.
Rastros: ¿dónde ocurrió el problema?
Las aplicaciones modernas a menudo dependen de varios servicios para completar una única acción del usuario. Una solicitud de pago puede pasar a través de una puerta de enlace API, un servicio de pedidos, un servicio de inventario y un proveedor de pagos antes de devolver un resultado.
El seguimiento distribuido registra la progresión de una solicitud a través de estos componentes, lo que permite examinar cuánto tiempo se dedicó a cada operación y dónde se produjeron los errores. Un seguimiento simplificado podría verse así:
Checkout request                 2,840 ms
├── Validate cart                  35 ms
├── Check inventory               110 ms
├── Calculate shipping            145 ms
└── Process payment             2,480 ms
    └── External payment API    2,410 ms
El seguimiento sugiere que la mayor parte del tiempo de la solicitud se dedicó a esperar al proveedor de pagos externo. Esta información puede guiar la investigación técnica. Es posible que el departamento de ingeniería deba examinar la latencia del proveedor, la configuración del tiempo de espera, las condiciones de la red o el manejo de las respuestas lentas por parte de la aplicación.
El proyecto OpenTelemetry proporciona estándares abiertos y herramientas para recopilar telemetría, incluidos seguimientos, métricas y registros.
3. Conectando los problemas técnicos con la experiencia del usuario
Un problema de producción se convierte en un problema de producto cuando afecta la capacidad de los usuarios para completar una acción prevista o recibir el valor esperado de la aplicación. Los paneles técnicos pueden mostrar la frecuencia de los errores, pero los Product Managers a menudo necesitan información adicional para comprender sus consecuencias.
Considere una plataforma de suscripción donde el servicio de autenticación experimente fallas intermitentes. Ingeniería informa que aproximadamente el 3 % de las solicitudes de inicio de sesión fallaron durante la hora anterior. Ese porcentaje proporciona una indicación inicial del problema, pero deja varias preguntas sin respuesta. ¿Se concentraron las fallas en un grupo particular de usuarios? ¿Podrían los clientes volver a intentarlo correctamente? ¿Se vieron afectados los clientes que pagaban? ¿El problema impidió que los usuarios accedieran a funciones esenciales?
Las respuestas pueden cambiar sustancialmente la evaluación de la gravedad. Una tasa de error del 3 % que afecta a todos los clientes durante un período de uso máximo puede requerir una respuesta diferente a la misma tasa de error que afecta a una herramienta de administración interna que se utiliza con poca frecuencia.
Medición del impacto de los problemas de producción
Los Product Managers pueden evaluar incidentes utilizando varias dimensiones:
| Dimensión | Pregunta |
|---|---|
| Alcance | ¿Cuántos usuarios o cuentas se vieron afectados? |
| Severidad | ¿Qué acciones ya no pueden realizar los usuarios? ¿Se completó? |
| Duración | ¿Cuánto tiempo persistió el problema? |
| Frecuencia | ¿La falla fue intermitente o constante? |
| Impacto en el negocio | ¿Afectó los pagos, las suscripciones u otros resultados comerciales? |
| Cliente contexto | ¿Se vieron afectados de manera desproporcionada determinados segmentos de clientes? |
Estas dimensiones ayudan a traducir los hallazgos técnicos en consecuencias para el producto. Por ejemplo, un tiempo de espera de pago que afecta a 200 intentos de pago no significa necesariamente que 200 clientes no pudieron comprar. Es posible que algunos intentos hayan sido reintentos y que algunos clientes hayan completado sus transacciones utilizando otro método.
Es posible que sea necesario combinar registros de solicitudes con registros de transacciones y análisis de productos para estimar el impacto real. La distinción es importante al comunicar un incidente a las partes interesadas. Informar el número de solicitudes fallidas como el número de clientes afectados puede producir una imagen engañosa del problema.
4. Investigar un problema de producción: un ejemplo práctico
Volviendo al problema de pago del comercio electrónico, supongamos que Soporte informa que varios clientes no pueden completar los pagos utilizando un método de pago en particular. El Product Manager quiere saber si el problema es aislado, cuántos clientes están afectados y si debería interrumpir el trabajo de desarrollo planificado.
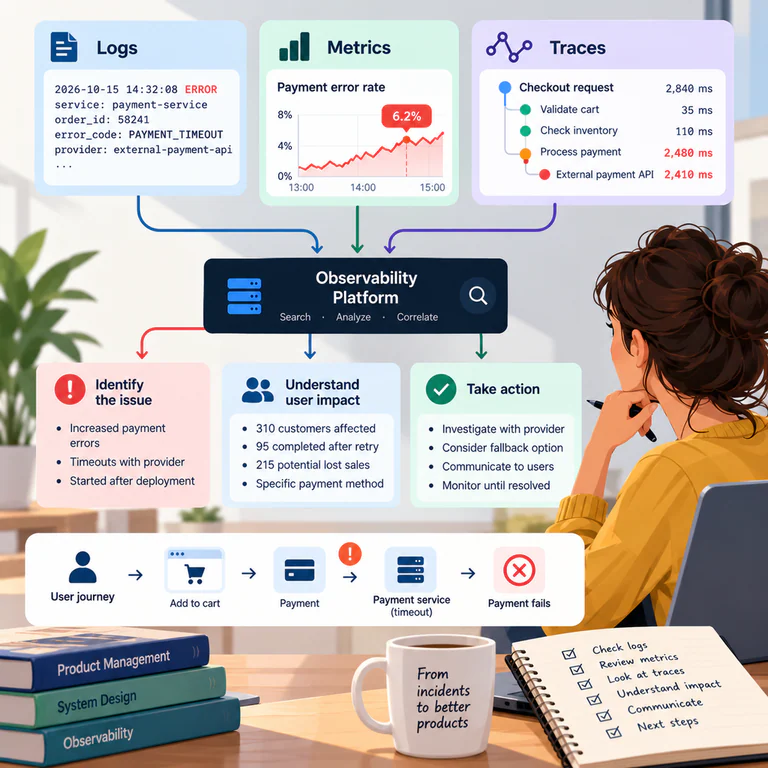
Paso 1: Establecer lo que están experimentando los usuarios
La investigación comienza con los informes de clientes disponibles. Es posible que el soporte haya recibido quejas que describen un mensaje de error después de que los clientes envían sus detalles de pago. Algunos clientes informan que volver a intentarlo produce el mismo resultado, mientras que otros eventualmente completan sus compras.
En esta etapa, es útil establecer el método de pago afectado, la hora aproximada en que ocurrió, la información del dispositivo o del navegador cuando esté disponible y cualquier identificador de transacción relevante. El objetivo es describir el comportamiento observado con suficiente precisión para que Ingeniería lo investigue sin asumir la causa técnica.
Paso 2: examinar el análisis del producto
El Product Manager puede comparar las tasas de finalización del proceso de pago antes y después de las primeras fallas reportadas. Supongamos que la tasa de conversión general ha disminuido solo ligeramente, pero la conversión para un método de pago ha caído del 74% al 41%.
Esto sugiere que el problema puede concentrarse en una parte particular de la experiencia de pago. Segmentar por método de pago, país, dispositivo o versión de la aplicación puede ayudar a limitar aún más la investigación.
Estas comparaciones deben tener en cuenta el volumen de tráfico y la variación normal. Un cambio porcentual grande basado en un puñado de transacciones puede ser menos informativo que un cambio más pequeño que afecte a miles de clientes.
Paso 3: Revisar las señales técnicas con ingeniería
Ingeniería examina el servicio de pago e identifica un aumento en los errores de tiempo de espera asociados con el proveedor afectado. El equipo puede utilizar una búsqueda de registros como:
service.name: "payment-service"
AND error.code: "PAYMENT_TIMEOUT"
La sintaxis exacta depende de la plataforma de registro y la estructura de los datos indexados. Los registros revelan cuándo ocurrieron los errores y qué solicitudes estuvieron involucradas. Las métricas muestran cómo cambió la tasa de errores con el tiempo, mientras que los seguimientos ayudan a determinar si los retrasos se originaron dentro de la aplicación o durante la comunicación con el proveedor.
Supongamos que la investigación muestra que la mayoría de las solicitudes afectadas esperaron varios segundos hasta que el proveedor se agotó. Esto proporciona evidencia de un problema de dependencia, aunque es posible que el equipo aún necesite determinar si el proveedor en sí está degradado o si la integración está manejando sus respuestas incorrectamente.
Paso 4: Estimar el impacto en el cliente y en el negocio
El Product Manager puede trabajar con Ingeniería y Datos para identificar la cantidad de clientes únicos afectados y la proporción que finalmente completó sus compras. Una evaluación útil podría incluir:
| Medida | Resultado ilustrativo |
|---|---|
| Intentos de pago fallidos | 460 |
| Clientes únicos afectados | 310 |
| Clientes que completaron posteriormente pago | 95 |
| Clientes sin una compra completa | 215 |
| Duración de las fallas elevadas | 52 minutos |
Estas cifras son hipotéticas y deberían derivarse de los datos reales de transacciones y eventos del producto. Aun así, los 215 clientes sin una compra completa no pueden ser tratados automáticamente como 215 ventas perdidas. Es posible que algunos hayan abandonado el pago por motivos no relacionados, mientras que otros pueden regresar más tarde.
No obstante, la estimación puede ayudar al equipo a comprender la posible exposición comercial y decidir si se justifica una intervención inmediata.
Paso 5: Decida la respuesta del producto
La respuesta adecuada depende de los hallazgos técnicos y de las alternativas disponibles. Si el proveedor experimenta una interrupción, el equipo podría desactivar temporalmente el método de pago afectado, enrutar transacciones elegibles a través de otro proveedor o comunicar el problema durante el pago.
Cada opción presenta compensaciones. Deshabilitar un método de pago puede evitar más intentos fallidos pero reducir las opciones de compra disponibles. Reintentar las transacciones automáticamente puede mejorar las tasas de recuperación, pero requiere salvaguardias contra cargos duplicados.
El Product Manager ayuda a evaluar estas opciones según el impacto en el cliente, el riesgo comercial y la duración esperada del incidente. Una vez que se resuelva el problema, el equipo debe verificar que las tasas de éxito de las transacciones hayan vuelto a la normalidad y examinar si algún cliente requiere seguimiento o conciliación.
5. Análisis de productos y observabilidad técnica
Los análisis de productos y la observabilidad técnica a menudo examinan el mismo recorrido del usuario desde diferentes perspectivas. El análisis de productos registra comportamientos como visitas a páginas, clics en botones, compras completadas y uso de funciones. La observabilidad técnica registra cómo los sistemas subyacentes procesan las solicitudes y responden a las condiciones operativas.
Un usuario puede hacer clic en el botón de pago, lo que activa un evento de análisis del producto. Luego, la aplicación envía una solicitud al servicio de pago, que genera registros, métricas y seguimientos. Si el pago falla, ambas perspectivas son relevantes. Los análisis de productos pueden mostrar si el cliente abandonó el proceso de pago o lo volvió a intentar, mientras que la telemetría técnica puede ayudar a identificar la operación que falló.
| Análisis de producto | Observabilidad técnica |
|---|---|
| Pago iniciado | Solicitud de API de pago recibida |
| Método de pago seleccionado | Solicitud de proveedor de pago iniciada |
| Compra completado | Autorización de pago exitosa |
| Pago abandonado | Tiempo de espera de solicitud o error de servicio |
| El usuario volvió a intentar el pago | Solicitud repetida o intento de transacción |
La relación entre estos eventos depende de la instrumentación de la aplicación. Los eventos de análisis de productos y las solicitudes técnicas pueden utilizar identificadores diferentes, lo que puede dificultar las investigaciones cuando no existe una forma confiable de conectarlos.
ID de correlación y recorridos de usuario
Un ID de correlación es un identificador utilizado para asociar operaciones o eventos relacionados. Por ejemplo, cuando comienza un proceso de pago, la aplicación puede generar un identificador de solicitud que se propaga a través de los servicios involucrados en el procesamiento de la transacción.
El departamento de ingeniería puede usar ese identificador para encontrar registros y seguimientos relacionados. En algunos sistemas, un identificador de sesión o de transacción también puede ayudar a conectar eventos técnicos con análisis de productos.
Estos identificadores deben diseñarse teniendo en cuenta los requisitos de privacidad y seguridad. La información personal confidencial, las credenciales de pago y los secretos de autenticación no deben exponerse en registros ni datos de seguimiento. Para los Product Managers, comprender cómo se pueden correlacionar los eventos es útil al definir los requisitos para investigar los recorridos críticos de los usuarios.
6. Definición de requisitos de observabilidad durante el desarrollo de productos
La observabilidad es más fácil de implementar cuando se consideran los requisitos de diagnóstico durante el desarrollo de funciones. Un equipo que introduce un nuevo proceso de renovación de suscripción, por ejemplo, puede definir cómo deben comportarse las renovaciones en condiciones normales, pero pasar por alto la información necesaria para investigar fallas después del lanzamiento.
Si los intentos de renovación no se registran de forma consistente, puede resultar difícil distinguir entre pagos rechazados, errores del proveedor, credenciales caducadas y problemas de procesamiento interno. El Product Manager puede ayudar a identificar los eventos y resultados que deben ser medibles.
Para un flujo de renovación de suscripción, las preguntas relevantes pueden incluir si se intentó la renovación, qué proveedor la procesó, si tuvo éxito, si se produjeron reintentos y si se notificó al cliente el resultado.
La ingeniería determina cómo instrumentar el sistema y qué telemetría se debe recopilar. La gestión de productos ayuda a establecer qué comportamientos y fallos son importantes para la experiencia del usuario y las operaciones comerciales.
Criterios de aceptación de observabilidad
Algunas características se benefician de requisitos explícitos de observabilidad junto con criterios de aceptación funcional. Por ejemplo:
- Los intentos fallidos de renovación deben ser identificables por categoría de error.
- El equipo debe poder distinguir los rechazos de pago de los fallos técnicos.
- El tiempo de procesamiento de la renovación debe ser mensurable.
- Los fallos repetidos deben poder detectarse mediante la supervisión.
- El soporte debe tener una forma segura de identificar el estado de la renovación de un cliente.
Estos requisitos son especialmente relevantes para el procesamiento de pagos, la autenticación, la sincronización de datos y otras operaciones donde las fallas pueden ser difíciles de diagnosticar para los clientes. Deben ser proporcionales al riesgo y la importancia operativa de la característica. Una mejora menor de la interfaz puede requerir poca instrumentación adicional, mientras que una nueva integración de pagos puede justificar capacidades de seguimiento y diagnóstico más amplias.
7. Utilizar la observabilidad para priorizar problemas técnicos
Los Product Managers a menudo necesitan comparar los problemas técnicos con el desarrollo de funciones y otras iniciativas de hoja de ruta. Un incidente que afecta a un gran número de usuarios claramente puede requerir atención inmediata. Otros problemas son menos sencillos, especialmente cuando ocurren de forma intermitente o no tienen ningún efecto obvio en las métricas comerciales principales.
Los datos de observabilidad pueden ayudar a estimar las consecuencias de dejar un problema sin resolver. Supongamos que un servicio de sincronización en segundo plano experimenta fallas recurrentes. La mayoría de los usuarios no son conscientes del problema, pero algunas cuentas reciben información desactualizada durante varias horas.
La ingeniería puede identificar la causa técnica y estimar el trabajo necesario para mejorar la confiabilidad. La gestión de productos puede investigar cuántos clientes dependen de la información afectada, con qué frecuencia ocurre el problema y si influye en el volumen de soporte o la satisfacción del cliente.
Esta evidencia respalda un debate sobre priorización más informado.
Frecuencia, gravedad e impacto empresarial
Tres dimensiones útiles son la frecuencia del problema, la gravedad de su efecto en los usuarios y las consecuencias comerciales. Un error de interfaz frecuente pero menor puede ser menos urgente que una falla poco común que provoque una facturación incorrecta. De manera similar, un problema de rendimiento que afecte a un flujo de trabajo empresarial de alto valor puede merecer atención incluso si relativamente pocas cuentas se ven afectadas.
Las métricas técnicas proporcionan evidencia sobre la frecuencia y el comportamiento del sistema. Los análisis de productos, los informes de los clientes y los datos comerciales ayudan a establecer las consecuencias. El equipo también debe considerar si el problema se está volviendo más frecuente, si existen soluciones temporales y si la condición técnica subyacente crea riesgos adicionales.
8. Observabilidad y confiabilidad del producto
La confiabilidad a menudo se describe a través de medidas técnicas como el tiempo de actividad, las tasas de error y la latencia. Estas medidas son útiles, pero su relevancia depende de qué operaciones de usuario representan. Un servicio puede lograr una alta disponibilidad general mientras que un recorrido importante del cliente experimenta fallas repetidas.
Por ejemplo, una aplicación podría permanecer accesible durante todo el día aunque su funcionalidad de exportación de documentos no esté disponible durante varias horas. La métrica general de tiempo de actividad del producto podría permanecer sin cambios, pero los clientes que dependen de las exportaciones experimentarían una interrupción significativa.
Indicadores y objetivos del nivel de servicio
Un indicador de nivel de servicio (SLI) es una medida del comportamiento de un servicio, como la proporción de solicitudes exitosas o el tiempo necesario para completar una operación. Un objetivo de nivel de servicio (SLO) define un objetivo para un SLI durante un período específico.
Para un servicio de pago, un SLI podría medir la proporción de solicitudes de pago válidas que reciben una respuesta técnica exitosa. Un SLO podría establecer el nivel aceptable de rendimiento durante un período continuo.
La definición exacta necesita atención. Un pago rechazado no necesariamente debe contarse como una falla en el servicio si el proveedor procesó correctamente la solicitud y devolvió un rechazo legítimo. Del mismo modo, una respuesta HTTP exitosa no siempre significa que el usuario completó la operación prevista.
Los equipos de Producto e Ingeniería pueden trabajar juntos para definir indicadores que representen aspectos significativos del recorrido del usuario sin dejar de ser técnicamente medibles.
La documentación de ingeniería de confiabilidad del sitio de Google proporciona antecedentes adicionales sobre la definición y el uso de SLO.
9. Comunicar los problemas de producción a las partes interesadas
Durante un incidente, las partes interesadas normalmente necesitan una explicación concisa de lo que está sucediendo, quién se ve afectado y qué está haciendo el equipo. Las investigaciones técnicas pueden involucrar registros detallados, rastreos, métricas de infraestructura y múltiples hipótesis en competencia. La mayoría de las partes interesadas no necesitan ese nivel de detalle, especialmente mientras la causa sigue siendo incierta.
Una actualización útil del incidente debería distinguir los hechos confirmados de las suposiciones. Por ejemplo:
Desde aproximadamente las 14:30 UTC, algunos clientes que utilizan un método de pago específico han experimentado fallas en el pago. Ingeniería ha identificado errores de tiempo de espera elevados en la integración de pagos y está investigando la causa. Otros métodos de pago parecen funcionar con normalidad. Estamos evaluando el número de clientes afectados y proporcionaremos otra actualización cuando el impacto y las opciones de recuperación sean más claras.
Esto comunica el comportamiento observado y la investigación actual sin presentar una causa raíz no confirmada como un hecho. Una vez que se resuelve el incidente, el equipo puede proporcionar una descripción más completa de la duración, el impacto en el cliente, la causa técnica, las acciones correctivas y cualquier trabajo de seguimiento.
Revisiones posteriores al incidente
Una revisión posterior al incidente examina lo que sucedió y cómo se podrían prevenir o detectar problemas similares antes. Para los Product Managers, la revisión puede revelar brechas en la experiencia del usuario, los procesos operativos y los requisitos del producto.
Una interrupción de pago puede exponer la ausencia de un método alternativo. Un error de autenticación puede mostrar que los clientes reciben mensajes de error poco claros. Un problema de sincronización puede revelar que el producto no comunica cuando la información está desactualizada.
Estos hallazgos pueden convertirse en elementos de la cartera de productos junto con mejoras técnicas como monitoreo adicional, mecanismos de reintento más seguros o una mejor gestión de dependencias.
10. Desarrollar la alfabetización en observabilidad como Product Manager
Los Product Managers que trabajan regularmente con incidentes de software se benefician al comprender la información disponible en las herramientas de observabilidad de su organización. Un punto de partida útil es revisar un panel de producción existente con Ingeniería e identificar qué métricas describen los viajes de usuario más importantes del producto.
El siguiente paso es examinar cómo aparece una falla específica en los registros, métricas y seguimientos. Seguir un incidente real desde el informe inicial del cliente hasta el diagnóstico técnico y la resolución ayuda a aclarar lo que cada fuente de información puede revelar.
Herramientas como Kibana, Grafana y plataformas de seguimiento distribuidas proporcionan diferentes formas de explorar datos operativos. Sus interfaces y capacidades varían, pero los conceptos subyacentes son transferibles. La participación del Product Manager dependerá de las responsabilidades y políticas de acceso del equipo. En algunas organizaciones, el Producto puede inspeccionar los paneles directamente. En otros, Ingeniería o Ingeniería de Confiabilidad del Sitio gestiona la investigación y comparte los hallazgos relevantes.
Para obtener una explicación más detallada de los registros, Kibana, la investigación de errores y la observabilidad técnica desde la perspectiva del producto, consulte Registros, Kibana y observabilidad para Product Managers, parte de The Product Shelf colección.
11. Hacer que el comportamiento de producción forme parte de las decisiones sobre el producto
Los problemas de producción brindan información sobre cómo se comporta un producto en condiciones reales, incluidas circunstancias que pueden ser difíciles de reproducir durante las pruebas. Una característica puede cumplir con sus requisitos funcionales y aun así encontrar problemas relacionados con el volumen de tráfico, dependencias externas, comportamiento inesperado del usuario o inconsistencias de datos.
La observabilidad hace que estas condiciones sean más fáciles de investigar, mientras que los análisis de productos y los comentarios de los clientes ayudan a establecer sus consecuencias. Para los Product Managers, la aplicación práctica es utilizar esta evidencia durante la evaluación de incidentes, la priorización de la hoja de ruta, la planificación de funciones y la evaluación posterior al lanzamiento. Un error técnico recurrente puede justificar cambios en la experiencia del producto, mientras que un problema de rendimiento aparentemente menor puede revelar un problema mayor cuando se examina en un segmento importante de clientes.
Después de la corrección, hay que comparar el recorrido afectado y las señales técnicas con los criterios de recuperación acordados. Conviene registrar las carencias de evidencia que persistan para evitar interpretar una caída de los errores registrados como una recuperación confirmada de los clientes.