

Los Product Managers trabajan con datos constantemente. Analizamos las tasas de conversión, la activación, la retención, la adopción de funciones y docenas de otras métricas para comprender lo que está sucediendo en un producto y decidir qué hacer a continuación.
Las cifras de un dashboard dependen de los registros almacenados, las transformaciones y las definiciones de las métricas. SQL permite examinar qué registros se han incluido, cómo se han combinado las tablas y si el cálculo corresponde a la pregunta de producto.
El punto de partida es el modelo de datos: qué representa cada registro, qué identificadores lo conectan con otros registros y qué limitaciones afectan a su interpretación.
¿Qué es SQL?
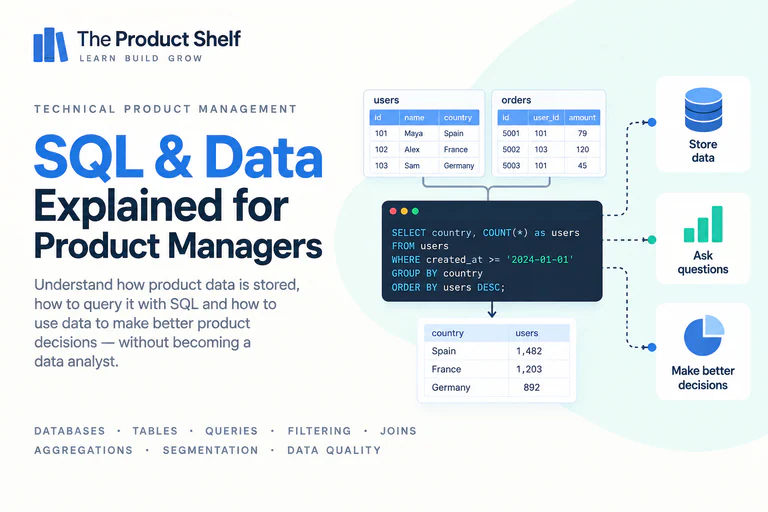
SQL – Lenguaje de consulta estructurado – es un lenguaje utilizado para interactuar con bases de datos relacionales. Le permite hacer preguntas sobre la información almacenada allí, recuperar registros específicos y combinar o resumir datos de diferentes maneras.
Con registros de clientes y pedidos, SQL permite contar quiénes compraron este mes, calcular el importe medio de los pedidos o identificar cuentas sin compras completadas. Cada pregunta selecciona una población y un cálculo distintos a partir de los mismos datos.
La base de datos contiene los registros subyacentes, mientras que SQL proporciona una forma de consultar esos registros y convertirlos en información útil. Para los Product Managers, esa suele ser la forma más útil de pensar en SQL: es una forma de hacer preguntas estructuradas sobre los datos que genera su producto.
¿Por qué los Product Managers deberían entender SQL?
Los paneles son útiles cuando la pregunta que desea responder ya ha sido anticipada. Si su panel de análisis contiene la tasa de activación por plataforma, simplemente puede abrirlo y mirar el número.
El trabajo de producto, sin embargo, tiende a generar nuevas preguntas. Quizás la activación cae repentinamente y quieres saber si el cambio afecta a todos los usuarios o sólo a los clientes de Android. Tal vez una característica esté funcionando bien en general, pero sospecha que los nuevos usuarios se comportan de manera diferente a los existentes. O tal vez una parte interesada hace una pregunta que nadie pensó en agregar a un panel.
Conocer la estructura de los datos permite concretar la pregunta antes de escribir la consulta. Un cambio en la activación necesita una cohorte definida, una acción que cuente como activación y un periodo en el que esa acción pueda producirse.
Ante una caída de activación, la investigación puede empezar por separar los nuevos usuarios elegibles por plataforma y comprobar qué paso ha cambiado. Así, un síntoma amplio se convierte en comparaciones que los datos permiten estudiar.
¿Cuándo cambió? ¿Qué usuarios se ven afectados? ¿Varía según la plataforma, el país, el canal de adquisición o la versión de la aplicación? Ese cambio de una pregunta vaga a una pregunta sobre datos comprobables suele ser más valioso que saberse la sintaxis SQL de memoria.
Tablas, filas y columnas.
Las bases de datos relacionales comúnmente organizan la información en mesas. Cada tabla suele representar un tipo de entidad o información, como clientes, pedidos, suscripciones o productos.
Imagine una tabla de clientes simple:
| id_cliente | nombre | país |
|---|---|---|
| 101 | ana | España |
| 102 | David | Francia |
| 103 | sara | España |
cada uno fila representa un registro, en este caso, un cliente, mientras que cada columna representa un atributo particular, como el nombre o el país del cliente.
Una tabla de pedidos puede contener información diferente:
| id_pedido | id_cliente | cantidad |
|---|---|---|
| 5001 | 101 | 49.99 |
| 5002 | 102 | 89.00 |
| 5003 | 101 | 25.50 |
Observe que ambas tablas contienen customer_id. Ese identificador compartido nos permite conectar a un cliente con sus pedidos, lo que se vuelve particularmente importante cuando comenzamos a combinar información de diferentes tablas.
Cada fila representa un registro con atributos y los identificadores conectan registros relacionados. Antes de combinar tablas hay que comprobar si una relación puede producir varias filas para un mismo cliente.
SELECCIONAR: recuperando datos
Una de las operaciones SQL más básicas es SELECCIONAR, que se utiliza para recuperar información de una tabla.
Por ejemplo:
SELECT *
FROM customers;
Esta consulta obtiene las columnas de la tabla de clientes. El resultado debe interpretarse según lo que representa cada registro de cliente.
* representa todas las columnas disponibles. Si solo desea información específica, puede solicitar campos individuales en su lugar:
SELECT customer_id, country
FROM customers;
La consulta identifica las columnas solicitadas y la tabla que las contiene. En un análisis de producción, seleccionar de forma explícita las columnas necesarias facilita la revisión del resultado.
DÓNDE: filtrado de datos
La mayoría de las preguntas sobre productos no se refieren a todos los registros de una base de datos. Por lo general, queremos centrarnos en un grupo en particular.
el DONDE La cláusula nos permite filtrar los datos.
Por ejemplo:
SELECT *
FROM customers
WHERE country = 'Spain';
En lugar de devolver todos los clientes, esta consulta sólo devuelve aquellos cuyo país es España. El filtrado define la población analizada. Los usuarios de Android, los clientes de Alemania o las cuentas creadas el mes pasado son subconjuntos distintos y pueden cambiar el denominador de una métrica.
La sintaxis puede cambiar según la pregunta, pero el pensamiento subyacente sigue siendo el mismo: ¿Qué usuarios o registros deberían incluirse en este análisis?
CONTE: ¿cuántos?
COUNT calcula el número de registros o valores que cumplen una consulta. El siguiente ejemplo cuenta los clientes cuyo país almacenado es España:
SELECT COUNT(*)
FROM customers
WHERE country = 'Spain';
El resultado cuenta los registros de cliente seleccionados. Si la pregunta se refiere a clientes que han pagado, la consulta necesita otra condición que establezca que completaron una compra. Los recuentos aparecen en todas partes en Gestión de productos: usuarios registrados, pedidos completados, cuentas activadas, pagos fallidos, solicitudes de soporte o personas que utilizaron una función en particular.
Pero incluso un simple recuento requiere una definición precisa. ¿Estamos contando clientes, cuentas, sesiones o eventos? ¿Puede aparecer el mismo usuario más de una vez? ¿Están incluidas las cuentas eliminadas? La consulta puede calcular el número perfectamente y al mismo tiempo responder a la pregunta incorrecta sobre el producto si la definición subyacente no es clara.
Agregaciones
SQL también puede resumir muchos registros en estadísticas útiles usando funciones de agregación.
Los ejemplos comunes incluyen:
COUNT— ¿cuántos registros?SUM— ¿cuál es el total?AVG: ¿cuál es el promedio?MIN: ¿cuál es el valor más pequeño?MAX: ¿cuál es el valor más grande?
Imagine una tabla de pedidos que contenga miles de transacciones. En lugar de inspeccionar cada pedido individualmente, podrías calcular:
SELECT AVG(amount)
FROM orders;
Esto le proporciona el valor promedio del pedido en los registros seleccionados. Las agregaciones son poderosas porque convierten grandes conjuntos de datos en números comprensibles. También es allí donde el contexto empieza a importar enormemente. Una media puede esconder comportamientos muy diferentes dentro de la población, por lo que muchas veces los Product Managers necesitan ir un paso más allá y segmentar el resultado.
GRUPO POR: comparar grupos
Un importe medio de pedido hipotético de 65 € describe el conjunto seleccionado. Un desglose por país permite comprobar si la cifra global oculta diferencias entre mercados. GROUP BY calcula un agregado por separado para cada grupo. El siguiente ejemplo agrupa los recuentos de clientes por país:
SELECT country, COUNT(*)
FROM customers
GROUP BY country;
En lugar de producir un recuento general de clientes, el resultado podría verse así:
| país | clientes |
|---|---|
| España | 4,820 |
| Francia | 3,410 |
| Alemania | 2,950 |
Agrupar permite ver las diferencias entre poblaciones. La activación por plataforma, mercado o canal de adquisición puede revelar un patrón oculto en la tasa global. Dividir un agregado en grupos puede revelar patrones que desaparecen por completo cuando todo se combina en un solo promedio.
ÚNETE: información de conexión
Los datos de productos rara vez se almacenan en una tabla gigante. La información del cliente puede estar en una tabla, los pedidos en otra y la información de suscripción en otro lugar.
un ÚNETE permite combinar datos de tablas relacionadas.
Recuerda nuestras dos mesas:
Clientes
| id_cliente | nombre | país |
|---|---|---|
| 101 | ana | España |
| 102 | David | Francia |
Órdenes
| id_pedido | id_cliente | cantidad |
|---|---|---|
| 5001 | 101 | 49.99 |
| 5002 | 102 | 89.00 |
Debido a que ambos contienen customer_id, podemos conectar cada pedido con el cliente que lo realizó.
Conceptualmente:
Clientes + id_cliente + Pedidos
Esto podría permitirnos responder preguntas como:
¿Cuál es el valor promedio de los pedidos por país del cliente?
Esa pregunta requiere información de ambas tablas: el monto del pedido proviene de la tabla de pedidos, mientras que el país proviene del registro del cliente. Combinar tablas introduce un riesgo en los recuentos: un cliente con varios pedidos aparece varias veces en un resultado a nivel de pedido. La unidad que se cuenta debe corresponder a la pregunta.
Identificadores
Los identificadores son los que permiten a los sistemas distinguir un registro de otro y, a menudo, proporcionan la conexión entre diferentes conjuntos de datos. Un usuario puede tener un user_id; un pedido, un order_id; una suscripción, un subscription_id. Una tabla relacionada puede almacenar uno de esos identificadores para asociar sus registros con la entidad correspondiente.
Estos identificadores se vuelven particularmente importantes al combinar datos. Los nombres y las direcciones de correo electrónico pueden cambiar o no ser únicos, mientras que un identificador interno generalmente está diseñado para hacer referencia a un registro específico.
Para los Product Managers, esto se vuelve relevante cuando se discuten cuestiones como si se pueden conectar datos de dos sistemas. Si su plataforma de análisis usa un identificador y el sistema de facturación usa otro, el equipo necesita alguna forma de mapear de manera confiable al mismo cliente en ambos sistemas.
NULL: faltar no siempre es cero
Un concepto que frecuentemente causa confusión en el análisis de datos es NULO. NULL generalmente representa la ausencia de un valor. No significa necesariamente cero, falso o una cadena vacía.
Imagine una tabla que contenga:
| cliente | compras |
|---|---|
| ana | 3 |
| David | 0 |
| sara | NULO |
David no ha realizado ninguna compra. Sin embargo, falta el valor de Sara. Quizás sus datos no fueron importados, no se realizó un seguimiento del campo cuando se registró o la información no está disponible por algún otro motivo.
Por lo tanto, tratar NULL como cero cambiaría el significado de los datos. Ésta es una pequeña distinción técnica con consecuencias analíticas potencialmente importantes. Antes de interpretar una métrica, vale la pena comprender qué significan los datos faltantes en ese conjunto de datos en particular.
Fechas y zonas horarias
El tiempo suena simple hasta que comienzas a analizar datos en todos los sistemas, países y zonas horarias. Imagínate que alguien pregunta:
"¿Cuántos pedidos recibimos ayer?"
Antes de responder, es posible que tengas que definir qué significa “ayer”. ¿Ayer en España? ¿UTC? ¿La hora local del cliente? ¿La zona horaria configurada en la plataforma de análisis? Un pedido realizado a las 00:30 en Madrid aún puede pertenecer al día natural anterior en otra zona horaria. Esto resulta particularmente importante al comparar informes generados por diferentes sistemas, porque es posible que no utilicen las mismas convenciones de tiempo.
Las fechas también se pueden almacenar en diferentes formatos o representar diferentes momentos: cuando se creó un pedido, cuando se confirmó el pago, cuando se envió o cuando se completó.
Entonces, siempre que una pregunta sobre un producto dependa del tiempo, asegúrese de comprender qué marca de tiempo se está utilizando y en qué zona horaria se interpreta.
Calidad de datos
Tener datos no significa automáticamente tener datos confiables. El seguimiento puede interrumpirse. Los eventos se pueden enviar dos veces. Un campo puede dejar de completarse después de un lanzamiento. Los datos históricos pueden utilizar una definición diferente a la de los datos actuales, o una plataforma puede comportarse de manera diferente a otra.
Imagine que su panel muestra que la activación ha caído repentinamente en un 20%. Eso podría significar que el comportamiento del usuario realmente ha cambiado, pero también podría significar que un evento utilizado para calcular la activación ya no se rastrea correctamente.
Antes de reaccionar ante una cifra sorprendente, vale la pena preguntarse si los datos en sí son saludables. Las comprobaciones útiles podrían incluir si el seguimiento cambió recientemente, si el movimiento afecta a todas las plataformas, si otra fuente de datos muestra el mismo patrón y si la definición de la métrica se ha mantenido consistente.
Antes de utilizar un resultado hay que comprobar que los eventos se recogieron según lo previsto y que la definición sigue correspondiendo al comportamiento del producto. Un fallo de instrumentación puede parecer una caída de uso.
SQL frente a herramientas de análisis
Los Product Managers suelen trabajar con herramientas que hacen posible el análisis sin escribir SQL. Los paneles, las plataformas de análisis de productos y las herramientas de inteligencia empresarial pueden proporcionar respuestas mucho más rápido que consultar directamente una base de datos.
Eso no hace que SQL sea irrelevante. Las herramientas de análisis suelen presentar datos según modelos, eventos y métricas que alguien ya ha definido. SQL puede resultar útil cuando la pregunta queda fuera de esas vistas predefinidas o cuando necesita investigar los datos subyacentes de manera más directa.
Los dos enfoques no son competidores. Un panel puede ser la forma más rápida de monitorear la activación cada semana, mientras que una consulta SQL puede ayudar a investigar por qué cambió la activación para un grupo específico de usuarios.
La mejor herramienta depende de la pregunta que intentas responder.
Traducir una pregunta sobre productos en una pregunta sobre datos
Una de las habilidades de datos más valiosas para un Product Manager es aprender a convertir una pregunta comercial amplia en algo medible. En un onboarding rediseñado, «mejor» necesita un resultado explícito. La tasa de finalización describe cuántas personas terminan; el tiempo de finalización mide la duración; la activación examina si después alcanzan el hito previsto. Estas medidas pueden moverse en direcciones distintas, por lo que conviene elegir el resultado antes de examinar los datos.
Es posible que luego necesite definir la población, el período de tiempo y la comparación: Nuevos usuarios expuestos a la incorporación B durante las últimas cuatro semanas frente a usuarios expuestos a la incorporación A durante las cuatro semanas anteriores.
En ese punto, la vaga pregunta original se ha convertido en algo que un analista, un panel o una consulta SQL realmente pueden investigar. Definir el resultado, la población y el periodo de observación da a la consulta un objetivo concreto. El criterio es el mismo si la escribe un PM, un analista o un ingeniero.
Preguntas que los Product Managers deberían hacer sobre los datos
Al observar una métrica o solicitar un análisis, es útil aclarar algunas cosas antes de sacar conclusiones precipitadas. Comience con el definición. ¿Qué estamos midiendo exactamente? Si hablamos de un usuario activado, ¿qué tiene que pasar para que alguien cuente como activado?
Entonces mira el población. ¿Qué usuarios están incluidos o excluidos? ¿Estamos analizando a todos los usuarios registrados, clientes de pago, cuentas nuevas o sólo a las personas que llegaron a un determinado punto del viaje?
El tiempo también importa. ¿Qué periodo analizamos, qué marca de tiempo se utiliza y con qué la comparamos? También vale la pena entender el fuente de la información. ¿Proviene de eventos analíticos, una base de datos de producción, un CRM u otro sistema? ¿El seguimiento es completo y fiable?
La segmentación puede revelar si un movimiento general esconde algo más específico. ¿Cambia el patrón según la plataforma, el mercado, el canal de adquisición, el tipo de cliente o la versión de la aplicación? Finalmente, tenga en cuenta la decisión. ¿Qué estamos tratando de aprender y qué haríamos de manera diferente dependiendo de la respuesta? El análisis de datos es mucho más útil cuando está relacionado con una decisión sobre un producto que cuando se realiza simplemente porque la información está disponible.
¿Los Product Managers necesitan saber SQL?
No todos los Product Managers necesitan escribir SQL con regularidad. La respuesta depende de la empresa, el producto y la facilidad con la que se puede acceder a los datos a través de otras herramientas. En algunas organizaciones, se espera que los PM consulten los datos ellos mismos. En otros, los analistas o equipos de datos manejan la mayor parte del trabajo de SQL. Muchas empresas se sitúan en un punto intermedio.
Las tablas, los filtros, las agregaciones y los JOINs aportan un vocabulario para revisar un análisis con Datos e Ingeniería. También permiten identificar supuestos sobre registros ausentes o usuarios duplicados. Con acceso a un entorno de análisis adecuado, las consultas sencillas permiten resolver directamente dudas habituales. Las definiciones complejas o los conjuntos de datos desconocidos siguen necesitando una revisión con el equipo responsable.
¿Cuánto SQL necesita un Product Manager?
Una base práctica incluye la obtención de registros, el filtrado, la agregación y las relaciones entre tablas. comprensión SELECCIONAR, DÓNDE, CONTAR, agregaciones básicas, GRUPO POR y ÚNAS ya le permite seguir una gran parte del análisis diario de productos. Igual de importante es comprender conceptos como identificadores, valores NULL, fechas, segmentación y calidad de los datos, porque a menudo es allí donde se producen errores analíticos.
En cada análisis conviene dejar por escrito la pregunta y qué evidencia cambiaría una decisión. Eso permite comprobar si la consulta responde a lo que el equipo pretendía investigar.
Profundice: SQL para Product Managers
Los ejemplos de SQL para analítica de producto aplican estos conceptos a la activación, los funnels y la retención, con las definiciones necesarias para interpretar cada cálculo.
SQL se vuelve mucho más poderoso cuando se conecta al contexto más amplio del producto. Comprender las bases de datos le ayuda a entender la arquitectura del software, mientras que saber cómo consultar y segmentar información le proporciona una base más sólida para trabajar con métricas de productos.
Continuar con el Gestión Técnica de Producto Ruta de aprendizaje para explorar API, arquitectura de software, métricas de productos, observabilidad, seguridad y CI/CD.
Explora el libro → SQL para Product Managers
Continuar aprendiendo Gestión Técnica de Producto
Explora el Centro de aprendizaje sobre gestión técnica de productos