

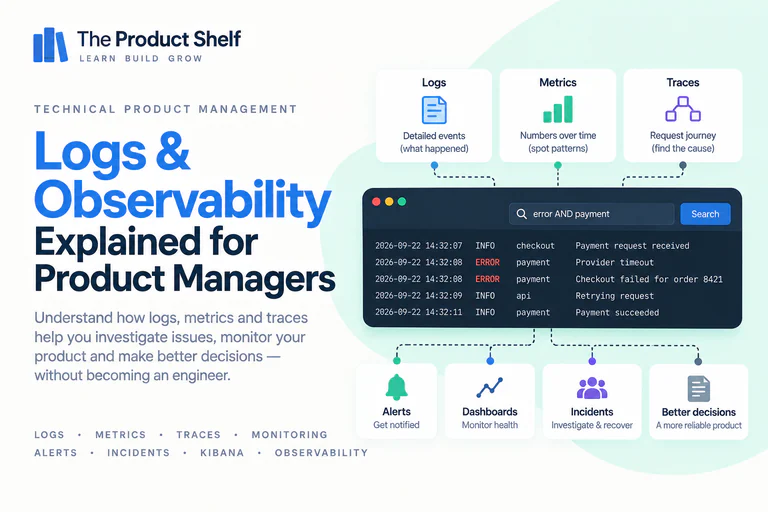
Un producto puede parecer perfectamente saludable desde fuera mientras algo ya anda mal por debajo. Un servicio de pago puede estar generando errores, una API puede responder repentinamente más lentamente o una nueva versión puede estar afectando solo a un pequeño porcentaje de usuarios.
Los logs registran eventos, las métricas resumen mediciones y las trazas siguen operaciones a través del sistema. El equipo utiliza estas señales para investigar el comportamiento en producción y evaluar si un cambio ha afectado a un recorrido de usuario.
Para Producto, la conexión con la experiencia del cliente aparece durante un incidente: qué recorrido falla, cuántas personas están afectadas y si existe una alternativa. Seguir las evidencias que examina Ingeniería permite apoyar esas decisiones en lo que se conoce.
¿Qué son los registros?
El software realiza acciones constantemente: los usuarios inician sesión, las solicitudes llegan a las API, se procesan los pagos, se ejecutan trabajos en segundo plano y los sistemas se comunican entre sí. Las aplicaciones pueden registrar información sobre muchos de estos eventos en registros.
Una entrada de registro podría indicarle que una solicitud llegó en un momento determinado, qué servicio la manejó, si tuvo éxito y, si algo falló, qué tipo de error ocurrió.
Dos entradas de ejemplo de un servicio de pagos podrían registrar una petición satisfactoria del pedido 8421 a las 10:42:31 y un timeout del proveedor para el pedido 8422 a las 10:43:07. La hora, el identificador y el resultado permiten localizar la actividad relacionada.
Una entrada de registro rara vez le informa todo sobre un problema del producto, pero miles o millones de ellas crean un registro detallado de lo que ha estado haciendo el software. Para los Product Managers, es útil comprender los registros porque a menudo proporcionan evidencia técnica detrás de declaraciones como “estamos viendo errores en el pago” o “el problema solo parece afectar las solicitudes a este servicio”.
¿Por qué los Product Managers deberían comprender los registros?
Imagínese que el servicio de atención al cliente informa que algunos usuarios no pueden completar el pago. El panel de análisis del producto puede mostrar que la conversión ha disminuido, pero probablemente no explique lo que sucedió dentro del sistema.
El departamento de ingeniería podría examinar los registros y descubrir que las solicitudes a un proveedor de pagos están caducando. La investigación ha pasado por varias capas:
Conversión de pago ↓ → Usuarios informando fallas → Errores de pago en registros → Tiempo de espera del proveedor externo
Los logs pueden relacionar el fallo del checkout con un timeout del proveedor. Ese hallazgo aún requiere investigación: hay que determinar qué peticiones fallaron y si los clientes consiguieron pagar después de reintentarlo.
También ayuda a la hora de informar problemas. "El pago no funciona" le da a Ingeniería mucho menos con qué trabajar que saber cuándo ocurrió el problema, qué recorrido del usuario se vio afectado y si hay identificadores que pueden ayudar a localizar la actividad correspondiente en los registros.
¿Qué información puede contener un registro?
La información exacta registrada depende de la aplicación, pero los registros suelen contener detalles como una marca de tiempo, el servicio o componente involucrado, la acción que se realiza, el resultado e información sobre cualquier error que haya ocurrido.
También pueden contener identificadores que permiten a los ingenieros conectar un evento con una solicitud, transacción o proceso en particular. Por ejemplo: Marca de tiempo: 10:43:07
Servicio: Servicio de pago
ID de pedido: 8422
Acción: Procesar pago
Resultado: ERROR
Razón: Tiempo de espera del proveedor No todos los sistemas registran la misma información y existen importantes consideraciones de seguridad y privacidad sobre lo que debería y no debería aparecer en los registros. Pero el propósito básico es consistente: los registros dejan evidencia que puede ayudar a los equipos a reconstruir lo que estaba haciendo el software en un momento particular.
Niveles de registro
No todos los eventos registrados por una aplicación tienen la misma importancia. Los equipos suelen utilizar niveles de registro para distinguir la información de rutina de los problemas potenciales.
Puedes encontrar niveles como:
- DEBUG: información detallada útil principalmente durante la investigación o el desarrollo.
- INFO: eventos normales que describen lo que está haciendo la aplicación.
- ADVERTENCIA: ocurrió algo inusual, aunque es posible que el sistema aún esté funcionando.
- ERROR: falló una operación o se produjo un problema importante.
Las convenciones exactas varían entre equipos, por lo que un ERROR no significa automáticamente que todo el producto esté roto. Puede representar una operación fallida entre millones de operaciones exitosas. Por eso el contexto es importante. Ver 100 errores suena preocupante hasta que sabes si provienen de 120 solicitudes o de 20 millones.
¿Qué es Kibana?
Cuando las aplicaciones generan enormes volúmenes de registros, leer archivos individuales no es práctico. Herramientas como Kibana permiten a los equipos buscar, filtrar y explorar esa información de manera mucho más eficiente. Un ingeniero que investigue un problema de pago podría filtrar los registros por un período de tiempo específico, servicio, tipo de error, identificador de pedido u otros campos disponibles. En lugar de revisar todo lo que produjo el sistema, pueden limitar la búsqueda a la actividad relevante para el incidente.
Por ejemplo, una investigación podría comenzar con:
Hora: 14:00–14:15
Servicio: servicio de pago
Nivel: ERROR
y luego estrechar aún más cuando aparece un patrón. Una búsqueda en Kibana acota los eventos por fecha, servicio u otro campo. El resultado representa los registros que cumplen esos filtros; la ausencia de registros puede deberse a la búsqueda, a las reglas de conservación o a carencias en la instrumentación.
Buscar y filtrar registros
Los registros resultan útiles cuando puedes reducir un gran volumen de información a los eventos relevantes para el problema que estás investigando. Supongamos que un cliente informa que un pedido falló aproximadamente a las 15:32. Si conoce el ID del pedido, Ingeniería podrá buscar ese identificador y seguir lo que sucedió a medida que la solicitud avanzaba por el sistema.
Por lo tanto, un informe útil podría incluir:
Usuario: cliente afectado
Hora: aproximadamente 15:32
ID del pedido: 8421
Acción: intento de pago
Resultado observado: pago fallido Esa información le brinda al equipo varias formas posibles de encontrar los eventos técnicos correspondientes.
Un informe con la hora, el recorrido y el identificador pertinente da a Ingeniería un punto de partida para localizar eventos. Los datos sensibles de cuentas o pagos deben permanecer en los sistemas de soporte aprobados por el equipo.
Correlación e ID de solicitud
Una única acción de usuario puede pasar por varios servicios antes de completarse. Imagine una solicitud de pago pasando por:
Frontend → Servicio de pago → Servicio de pedido → Servicio de pago → Proveedor de pago
Si cada componente genera sus propios registros, investigar el recorrido completo puede resultar difícil. Por lo tanto, los equipos suelen utilizar identificadores que permiten conectar eventos relacionados. Un ID de solicitud o un ID de correlación puede viajar con la solicitud a medida que avanza por el sistema. Luego, los ingenieros pueden buscar ese identificador y reconstruir lo que sucedió en varios componentes.
Conceptualmente:
Solicitud ABC123
→ Servicio de pago
→ Servicio de pedidos
→ Servicio de pago
→ Proveedor externo
Para los Product Managers, la idea importante es simplemente que una acción de usuario puede generar actividad en muchos sistemas, y los equipos necesitan formas de conectar esas piezas durante una investigación.
Registros frente a métricas
Los registros proporcionan registros detallados de eventos individuales, mientras que las métricas del sistema resumen el comportamiento a lo largo del tiempo. Una entrada podría registrar que la petición 8421 falló a las 10:43:07. Una métrica podría resumir el periodo con una tasa de error de pago del 8,4% durante diez minutos. Estas cifras hipotéticas responden a preguntas distintas: la entrada identifica un evento y la tasa describe su frecuencia en una población definida.
Ambos son útiles, pero responden a preguntas diferentes. Las métricas suelen ser mejores para mostrar que algo inusual está sucediendo en todo el sistema, mientras que los registros pueden ayudar a investigar eventos individuales y comprender qué sucedió realmente.
Un equipo podría notar primero un aumento en una métrica de tasa de error y luego usar registros para investigar las fallas detrás de ese aumento. Esta relación entre señales de alto nivel y evidencia detallada es fundamental para comprender la observabilidad.
¿Qué es la monitorización?
Monitoreo implica realizar un seguimiento continuo de señales seleccionadas para que los equipos puedan comprender si un sistema se está comportando dentro de los límites esperados.
Un equipo podría monitorear:
- Tasa de errores
- Tiempo de respuesta
- Uso de CPU o memoria
- Volumen de solicitudes
- Pagos fallidos
- La aplicación falla
Estas señales se pueden mostrar en paneles y observar a lo largo del tiempo. El equipo ya sabe que estas cosas son importantes, por lo que las mide deliberadamente. Por ejemplo, un panel podría mostrar:
Tasa de error de API: 0,3 %
Tiempo de respuesta promedio: 220 ms
Tasa de éxito de pago: 98,7 % Si uno de esos valores cambia significativamente, puede proporcionar una indicación temprana de que algo necesita atención.
Alertas
Los equipos no pueden monitorear cada panel continuamente, por lo que los sistemas de monitoreo pueden generar alertas cuando ocurren ciertas condiciones. Una regla de ejemplo podría generar una alerta cuando la tasa de error de pago permanezca por encima del 5% durante cinco minutos. Otra podría vigilar una medida definida del tiempo de respuesta de la API. Los umbrales necesitan un periodo de medición, una definición clara y una acción que pueda realizar quien recibe el aviso.
Una alerta no necesariamente explica el problema. Le indica al equipo que se ha cumplido una condición predefinida y que es posible que alguien deba investigar. Esta distinción es importante porque una alerta es el comienzo de una investigación, no el diagnóstico en sí. “Se disparó la alerta de error de pago” le indica qué señal cambió; la siguiente pregunta es por qué.
Monitoreo versus observabilidad
El seguimiento y la observabilidad están estrechamente relacionados, pero no son exactamente lo mismo. El monitoreo se centra en gran medida en señales conocidas. El equipo decide de antemano qué importancia tienen la tasa de error, la latencia o el uso de la CPU y los rastrea.
Observabilidad es la capacidad más amplia de comprender lo que sucede dentro de un sistema examinando la información que produce. Se vuelve particularmente valioso cuando sucede algo inesperado y el equipo aún no cuenta con un panel diseñado específicamente para ese problema.
La monitorización comprueba condiciones seleccionadas a lo largo del tiempo. Un fallo inesperado del checkout puede exigir examinar señales que esas comprobaciones no contemplan, seguir una petición por varios servicios o comparar el tráfico afectado con el que funciona. La instrumentación disponible determina hasta dónde puede llegar la investigación.
En la práctica, los dos se superponen significativamente y los equipos pueden usar los términos de maneras ligeramente diferentes.
Registros, métricas y seguimientos
Tres tipos de información suelen aparecer en las conversaciones sobre observabilidad: registros, métricas y seguimientos.
Losregistros proporcionan registros detallados de eventos individuales. Las métricas resumen el comportamiento numéricamente a lo largo del tiempo. Los seguimientos ayudan a mostrar cómo se mueve una solicitud a través de diferentes partes de un sistema distribuido.
Juntos, proporcionan diferentes perspectivas sobre un mismo producto:
LOGS → ¿Qué pasó?
MÉTRICAS → ¿Cuánto o con qué frecuencia?
RASTREOS → ¿A dónde fue la solicitud?
Imagínese que el pago de repente se vuelve lento. Una métrica podría revelar que el tiempo de respuesta se ha duplicado. Un seguimiento podría mostrar que la mayor parte del retraso ocurre cuando el Servicio de Pago llama a un proveedor externo, mientras que los registros de ese servicio pueden contener información más detallada sobre lo que sucedió durante esas solicitudes.
Ninguna de estas señales necesita contar toda la historia por sí sola.
¿Qué son las trazas?
Las aplicaciones modernas pueden implicar que muchos servicios se comuniquen entre sí. Un rastreo sigue a una solicitud a medida que avanza a través de esos componentes.
Imagina que un usuario envía un pedido:
Frontend → Pago → Pedidos → Pagos → Base de datos
La solicitud total demora tres segundos, pero eso por sí solo no nos dice dónde se invirtió el tiempo. Un seguimiento podría revelar: Pago: 100 ms
Pedidos: 150 ms
Pagos: 2600 ms
Base de datos: 80 ms
Ahora el equipo tiene un lugar mucho más claro para investigar. Las trazas muestran cómo se reparte el tiempo de una petición instrumentada. Su cobertura depende de los servicios y llamadas externas que emitan información de trazado; una traza incompleta puede dejar parte de la espera sin explicar.
¿Qué es un incidente?
Un incidente es un evento que interrumpe o degrada el funcionamiento normal de un producto o sistema. Podría afectar a todos o sólo a un subconjunto de usuarios, y la gravedad puede variar desde una degradación menor hasta una interrupción total de una capacidad crítica.
Los ejemplos podrían incluir que el proceso de pago no esté disponible, los errores de inicio de sesión aumenten dramáticamente, una API responda extremadamente lentamente o una versión móvil que provoque que la aplicación falle para ciertos usuarios. Durante un incidente, la prioridad suele ser comprender el impacto, restaurar el servicio y reducir los daños lo más rápido posible. La determinación de la causa raíz más profunda puede ocurrir después de que se haya estabilizado el problema inmediato.
Para los Product Managers, los incidentes a menudo requieren coordinación entre la investigación técnica y el impacto del producto: ¿Qué está roto? ¿Quién se ve afectado? ¿Qué tan grave es? ¿Existe alguna solución? ¿Qué necesitan saber los clientes?
Un flujo de incidente típico
Aunque cada organización maneja los incidentes de manera diferente, el proceso general suele seguir un patrón reconocible:
Detección → Triaje → Investigación → Mitigación → Recuperación → Aprendizaje
El problema puede detectarse primero a través de una alerta automática, una métrica del producto, atención al cliente o incluso los usuarios que lo informan directamente. Luego, el equipo intenta comprender el alcance y la gravedad antes de investigar la causa técnica. Una vez que se sabe lo suficiente, pueden mitigar el problema desactivando una función, deteniendo una implementación, revirtiendo una implementación o utilizando otro mecanismo de recuperación.
Una vez que el servicio se haya recuperado, el enfoque puede pasar de “¿Cómo detenemos el impacto?” a “¿Por qué sucedió esto y qué deberíamos cambiar como resultado?” Los Product Managers pueden desempeñar un papel importante a lo largo de este proceso al ayudar a cuantificar el impacto del usuario, priorizar los viajes críticos y coordinar las decisiones que afectan a los clientes.
Métricas del producto frente a métricas del sistema
Los equipos de producto y los equipos de ingeniería suelen observar diferentes tipos de señales, y ambas pueden ser necesarias para comprender lo que está sucediendo.
Una métrica del sistema podría mostrar:
Tasa de error de API ↑
mientras una métrica de producto muestra:
Conversión de pago ↓
La métrica técnica nos dice que algo ha cambiado en el sistema. La métrica del producto nos dice que el cambio puede estar afectando el comportamiento del cliente. Ninguno de los dos prueba automáticamente que el otro lo causó, pero ver a ambos moverse al mismo tiempo le da al equipo una fuerte razón para investigar la relación.
Es por eso que la observabilidad no debe tratarse como algo completamente separado de Product Analytics. El comportamiento técnico puede tener consecuencias directas en el producto y, a veces, la primera señal de un problema técnico aparece en una métrica empresarial o de producto.
La observabilidad no es sólo para los incidentes
La observabilidad a menudo se asocia con interrupciones, pero también puede ayudar a los equipos a comprender el comportamiento normal del producto. Supongamos que una nueva función depende de una API externa. Después del lanzamiento, es posible que el equipo quiera saber con qué frecuencia se llama a esa API, cuánto tiempo lleva responder, con qué frecuencia fallan las solicitudes y si el uso está creciendo como se esperaba.
Esas señales pueden revelar limitaciones potenciales antes de que se conviertan en incidentes. Lo mismo se aplica después de un lanzamiento. Ingeniería puede monitorear el estado técnico mientras el Producto observa la adopción, conversión u otras métricas de comportamiento. Juntas, esas señales proporcionan una imagen mucho mejor de si la versión está funcionando según lo previsto.
Después de un lanzamiento, estas señales pueden revelar un aumento de la latencia del proveedor o un volumen de llamadas inesperado antes de recibir reclamaciones. Compararlas con las métricas de producto permite evaluar su efecto sobre el recorrido.
Preguntas que los Product Managers deberían hacer sobre la observabilidad
Para cada funcionalidad crítica, el equipo puede acordar qué señales revisará tras el lanzamiento, quién recibirá las alertas y qué resultado de usuario permiten evaluar. Para un viaje crítico, es útil saber qué monitorea el equipo y qué tan rápido un problema se haría visible. Si el pago comienza a fallar, ¿se activaría una alerta en cuestión de minutos o el equipo solo la descubriría cuando los clientes comenzaran a comunicarse con el soporte?
También puede preguntar qué información estaría disponible durante una investigación. ¿Existen registros para los servicios relevantes? ¿Se pueden rastrear las solicitudes entre sistemas? ¿Se pueden desglosar los fallos por plataforma, versión o proveedor?
La recuperación también es importante. Una vez que se ha detectado un problema, ¿quién recibe la alerta, quién es el propietario del sistema afectado y qué opciones existen para reducir el impacto? Estas preguntas no tratan sobre la gestión de la configuración de observabilidad de Ingeniería. Se trata de comprender con qué confianza la organización puede operar el producto una vez que está en manos de los usuarios.
Escribir informes de errores útiles
Una forma práctica en que los Product Managers pueden ayudar en las investigaciones técnicas es proporcionando buena información al informar un problema. Un informe hipotético podría indicar que la cuenta 4821 intentó pagar a las 14:32 CET, recibió un error tras enviar los datos de tarjeta y reprodujo el problema dos veces en la versión 4.6 de Android, con el pedido 8421. Esto da a Ingeniería un periodo e identificadores para investigar sin dar por establecida la causa.
La información útil puede incluir la hora en que ocurrió el problema, identificadores de cuenta o usuario cuando corresponda, ID de pedido o transacción, versión de la aplicación, plataforma, entorno, pasos seguidos y el resultado que vio el usuario.
El informe debe permitir situar el recorrido afectado en el tiempo y conectarlo con los registros disponibles. Cuando falte un identificador, conviene dejar constancia de esa limitación junto con los hechos conocidos.
¿Los Product Managers necesitan saber Kibana?
El acceso a Kibana varía entre organizaciones. Algunos PMs pueden consultar los logs directamente; otros trabajan con Ingeniería porque los registros de producción contienen información sensible o requieren una interpretación especializada. Sin embargo, sentirse cómodo con la idea básica de buscar y filtrar registros puede resultar sorprendentemente útil. Si un ingeniero comparte una pantalla Kibana durante un incidente, debería poder comprender que está viendo eventos producidos por el sistema, filtrados según elementos como tiempo, servicio o tipo de error.
Cuando el equipo comparte una búsqueda, conviene empezar por el intervalo temporal, los filtros y los identificadores. Esas decisiones determinan qué eventos se están viendo.
¿Los Product Managers necesitan comprender la observabilidad?
Durante un incidente, Producto puede concretar los recorridos afectados y el impacto sobre los clientes mientras Ingeniería investiga la causa técnica. Ambas evaluaciones pueden cambiar con la llegada de nuevas evidencias. Una base útil incluye conocer la función de los registros, niveles de registro, métricas, monitoreo, alertas, seguimientos, ID de correlación y gestión de incidentes, así como comprender cómo estas señales técnicas pueden conectarse con las métricas del producto.
Ese reparto del trabajo también orienta las prioridades de recuperación: restablecer un flujo crítico de pago puede tener preferencia sobre reparar una tarea en segundo plano menos perjudicial, aunque ambas generen errores.
Profundice: registros, Kibana y observabilidad para Product Managers
El libro Logs, Kibana y Observabilidad para Product Managers desarrolla las búsquedas en logs, la monitorización, las trazas y la evaluación de incidentes con ejemplos de producto.
La observabilidad se conecta naturalmente con varias otras áreas de la gestión técnica de productos. La arquitectura del software le ayuda a comprender los componentes que producen estas señales, las API explican cuántos de esos sistemas se comunican, las métricas del producto muestran cómo el comportamiento técnico puede afectar a los usuarios y CI/CD explica cómo los nuevos cambios llegan a producción en primer lugar.
Continúe con la ruta de aprendizaje de Gestión técnica de productos para explorar API, arquitectura de software, SQL y datos, métricas de productos, seguridad y CI/CD.
Explore el libro → Registros, Kibana y observabilidad para Product Managers
Continuar aprendiendo Gestión Técnica de Productos
Explore el Centro de aprendizaje sobre gestión técnica de productos