

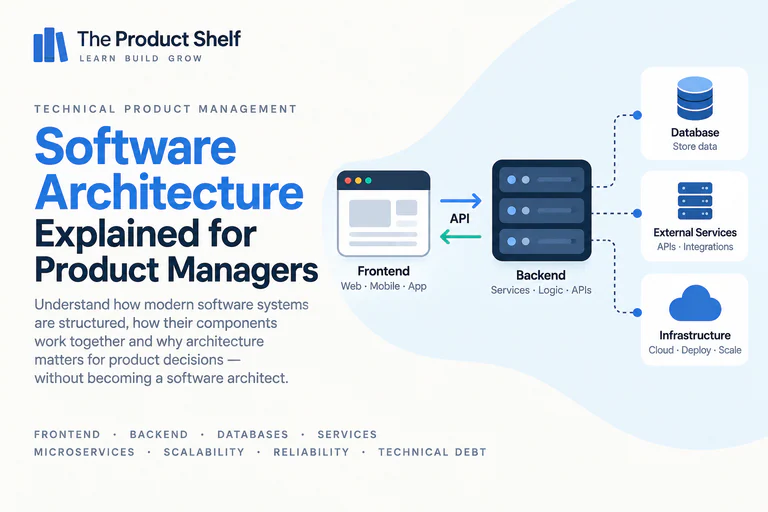
La arquitectura de software condiciona el trabajo necesario para cambiar un producto digital. Una pantalla puede depender de varios servicios, datos almacenados y proveedores externos, cada uno con sus restricciones y responsables.
Dos diseños similares pueden tener costes de desarrollo distintos. Reutilizar información que un servicio ya tiene disponible puede ser sencillo; introducir una dependencia puede exigir cambios en las APIs, los permisos y los flujos de datos.
Conocer estos componentes permite a Producto e Ingeniería concretar el alcance, identificar dependencias y evaluar las consecuencias de un cambio.
¿Qué es la arquitectura de software?
La arquitectura de software describe cómo se organizan las partes principales de un sistema de software y cómo interactúan entre sí. Un producto digital que para el usuario parece una única aplicación, en realidad puede constar de muchos componentes diferentes detrás de escena. Una arquitectura simplificada podría verse así:
Usuario → Frontend → Backend → Base de datos
El frontend presenta la interfaz, el backend maneja gran parte de la lógica de la aplicación y la base de datos almacena información. En un producto real, la imagen puede ser considerablemente más compleja. El backend puede constar de varios servicios, el producto puede comunicarse con proveedores externos, los datos pueden almacenarse en diferentes sistemas y los componentes de infraestructura pueden ubicarse entre ellos.
La arquitectura es esencialmente la estructura que permite que todas esas piezas funcionen juntas. Un cambio en la interfaz puede exigir trabajo en varios de esos componentes. Identificarlos durante el discovery permite detectar dependencias que, de otro modo, aparecerían durante la implementación.
¿Por qué los Product Managers deberían comprender la arquitectura de software?
Porque la arquitectura afecta lo que se puede construir, lo difícil que es cambiar y qué tipos de riesgos o dependencias introduce una característica. Imagine dos características que parecen igualmente simples en un diseño. El primero utiliza información que ya existe en el mismo sistema y está fácilmente disponible. El segundo necesita datos que pertenecen a otro servicio, requiere cambios en una API y depende de un proveedor externo.
Desde la perspectiva del usuario, ambas funciones pueden equivaler a agregar un pequeño elemento a una pantalla. Sin embargo, desde una perspectiva de ingeniería, pueden ser trabajos completamente diferentes. La estimación depende de los cambios necesarios en esos sistemas, incluida la coordinación con otros equipos y las pruebas de los recorridos afectados. El tamaño del elemento en pantalla aporta poca información sobre ese trabajo.
Frontend y backend
Una de las distinciones más comunes que escuchará es entre el frontend y el backend. La interfaz es la parte del producto con la que los usuarios interactúan directamente: pantallas, botones, formularios, navegación y otros elementos visibles. El backend se ejecuta detrás de la interfaz y maneja aspectos como la lógica empresarial, el procesamiento de datos, los permisos y la comunicación con otros sistemas.
Una interacción simplificada podría verse así:
Usuario → Frontend → Backend → Base de datos
y el resultado regresa:
Usuario ← Frontend ← Backend ← Base de datos
Imagine a un usuario abriendo su historial de pedidos. La interfaz muestra la pantalla, pero es posible que deba solicitarle al backend los pedidos relevantes. El backend recupera esa información de una base de datos u otro servicio y la devuelve al frontend, que la presenta al usuario.
Esta es la razón por la que una función que parece ser “solo una pantalla nueva” puede requerir trabajo tanto de frontend como de backend.
Clientes y servidores
También escuchará a los ingenieros hablar sobre clientes y servidores. Un cliente generalmente es el software que solicita algo, mientras que un servidor recibe esa solicitud y proporciona una respuesta o realiza algún trabajo.
Un navegador web puede ser un cliente. Una aplicación móvil también puede ser un cliente. Ambos pueden comunicarse con el mismo servidor backend:
Aplicación web ─┐
** ├──→ Backend**
Aplicación móvil ─┘
Esto se vuelve relevante cuando un producto existe en varias plataformas. Un cambio de backend puede admitirlos todos, mientras que un cambio en la interfaz de iOS afecta solo a la aplicación de iOS.
Comprender dónde debe realizarse un cambio hace que las discusiones sobre el alcance y las dependencias sean mucho más claras.
Bases de datos
La mayoría de los productos de software necesitan un lugar para almacenar información. Esto puede incluir usuarios, suscripciones, pedidos, mensajes, transacciones, preferencias o casi cualquier otra cosa que el producto deba recordar. Una base de datos proporciona almacenamiento estructurado para esa información. En una arquitectura simplificada:
Frontend → Backend → Base de datos
La interfaz normalmente no accede a la base de datos directamente. En su lugar, solicita información al backend, y el backend determina qué datos deben recuperarse o modificarse. Para los Product Managers, las bases de datos se vuelven relevantes cada vez que una función requiere información que no existe actualmente, está almacenada en otro lugar o se representa de manera diferente a lo que requiere el nuevo caso de uso. Un diseño puede solicitar mostrar un nuevo atributo de cliente, por ejemplo, pero antes de que ese campo pueda aparecer en la interfaz, el equipo necesita saber si la información realmente se está almacenando y de dónde proviene.
Aquí también es donde resulta útil comprender algunos conceptos básicos de datos y SQL, porque la forma en que se almacena la información afecta la facilidad con la que el producto puede consultarla, analizarla y utilizarla posteriormente.
Servicios
A medida que el software crece, las diferentes responsabilidades pueden separarse en diferentes servicios.
Una plataforma de comercio electrónico, por ejemplo, puede contener áreas separadas responsables de:
Usuarios → Pedidos → Pagos → Notificaciones → Envío
Estos no corresponden necesariamente a cinco aplicaciones completamente independientes, pero ilustran cómo se pueden dividir las responsabilidades dentro de un sistema más grande. Cuando una función afecta a varias de estas áreas, es posible que sea necesario coordinar varios servicios (y, a veces, varios equipos de ingeniería). Un cambio en el proceso de pago podría involucrar el sistema de pedidos, el procesamiento de pagos, el inventario y las notificaciones, aunque el usuario lo experimente como un viaje continuo.
Comprender los servicios ayuda a los Product Managers a identificar esas dependencias antes en lugar de descubrirlas a mitad de la entrega.
Monolitos y microservicios
Dos términos que aparecen a menudo en las conversaciones sobre arquitectura son monolito y microservicios. En una arquitectura monolítica, muchas capacidades están contenidas dentro de una aplicación más grande. Conceptualmente:
Usuarios + Pedidos + Pagos + Notificaciones → Una aplicación
Con los microservicios, esas responsabilidades se pueden separar en servicios más pequeños operados de forma independiente:
Servicio de usuario
Servicio de pedido
Servicio de pago
Servicio de notificación
Los microservicios pueden permitir a los equipos desarrollar, implementar y escalar partes de un sistema de forma más independiente, pero esa independencia también introduce una complejidad adicional de comunicación, operación y coordinación. Un monolito no es automáticamente malo y los microservicios no son automáticamente mejores. La arquitectura adecuada depende del producto, la organización, la escala y los problemas que el equipo intenta resolver.
Elegir una arquitectura implica compromisos entre velocidad de entrega, responsabilidad de los equipos, fiabilidad y mantenimiento. Los requisitos de producto aportan criterios para evaluar esas decisiones con Ingeniería.
Comunicación síncrona y asíncrona
Los sistemas no siempre se comunican de la misma manera.
Con la comunicación sincrónica, un componente le pide algo a otro componente y espera la respuesta antes de poder continuar.
Conceptualmente:
Servicio A → Solicitud → Servicio B → Respuesta → Servicio A continúa
Imagínese que el proceso de pago llama a un servicio de pago y espera a saber si el pago se realizó correctamente. El siguiente paso puede depender directamente de esa respuesta. Con la comunicación asincrónica, un sistema puede iniciar o publicar algo sin esperar a que finalice todo el trabajo posterior.
Por ejemplo, una vez que se ha creado un pedido, es posible que el cliente no necesite esperar mientras el sistema también envía un correo electrónico, actualiza los análisis y activa otros procesos en segundo plano. Esta distinción es importante porque afecta tanto la experiencia del usuario como la forma en que las fallas se propagan a través de un sistema. Si cada acción espera a que respondan otros sistemas, una dependencia lenta puede ralentizar toda la experiencia.
Colas y eventos
Los sistemas asincrónicos suelen utilizar conceptos como colas y eventos para coordinar el trabajo. Imagina que se acaba de crear un pedido. En lugar de que el servicio de pedidos realice directamente todas las acciones relacionadas, podría publicar un evento:
Pedido creado
Otras partes del sistema pueden reaccionar:
Pedido creado → Enviar correo electrónico de confirmación
** → Actualizar análisis**
** → Iniciar cumplimiento**
El servicio que crea el pedido no necesariamente necesita saber todo lo que sucederá después. Es posible que su responsabilidad principal ya esté completa. Para los Product Managers, el concepto útil es que no todo lo que hace un producto tiene que suceder inmediatamente o como parte de la misma solicitud. Esto puede ayudar a explicar por qué algunas acciones aparecen instantáneamente mientras que otras ocurren momentos después, y por qué diferentes partes de un viaje pueden fallar de forma independiente.
Almacenamiento en caché
Una caché almacena información temporalmente para reducir las consultas o los cálculos repetidos. Si muchos usuarios solicitan los mismos datos de un producto, servir una copia almacenada reduce el trabajo en la fuente original. El equipo debe decidir cómo y cuándo actualizarla.
Conceptualmente:
Usuario → Caché → Datos
en lugar de repetidamente:
Usuario → Backend → Base de datos → Datos
El almacenamiento en caché puede mejorar el rendimiento y reducir la carga, pero introduce otra consideración: la información almacenada en caché puede ser temporalmente más antigua que los datos de origen. Es por eso que los usuarios a veces pueden cambiar algo y no ver la actualización reflejada de inmediato. Es posible que la información subyacente ya haya cambiado mientras que otra parte del sistema todavía muestra una versión almacenada en caché.
Un precio o un nivel de stock en caché puede quedar desactualizado. La demora aceptable depende de lo que prometa la interfaz y de cuándo vuelva a comprobar la aplicación el valor de referencia.
Escalabilidad
Un sistema que funciona perfectamente para 1.000 usuarios puede comportarse de manera muy diferente con un millón. Escalabilidad es la capacidad de un sistema para manejar una demanda creciente sin que su rendimiento o confiabilidad se degraden más allá de niveles aceptables.
El crecimiento puede ejercer presión sobre muchas partes de una arquitectura: las bases de datos pueden recibir más consultas, las API pueden manejar más solicitudes, los trabajos en segundo plano pueden acumularse y los servicios de terceros pueden alcanzar límites de uso.
Esto significa que el crecimiento del producto puede eventualmente generar trabajo técnico incluso cuando no se agrega ninguna nueva característica orientada al usuario. Es posible que el departamento de ingeniería necesite mejorar la infraestructura, optimizar las consultas o rediseñar parte de un sistema simplemente para admitir la funcionalidad existente del producto a mayor escala.
Para los Product Managers, la escalabilidad no es, por lo tanto, una preocupación abstracta de ingeniería. Se convierte en una preocupación para el producto cada vez que el uso esperado cambia significativamente.
Fiabilidad y disponibilidad
Los usuarios esperan que los productos funcionen cuando los necesitan. La confiabilidad se refiere en términos generales a si un sistema se comporta de manera correcta y consistente, mientras que la disponibilidad se relaciona con si el sistema es accesible y capaz de atender a los usuarios.
Aumentar la confiabilidad generalmente requiere inversión. Los equipos pueden agregar redundancia, monitoreo, mecanismos de recuperación automatizados u otras salvaguardas, pero cada uno de ellos tiene un costo en tiempo, infraestructura y complejidad. Esto crea una compensación de producto. No todas las capacidades necesitan necesariamente el mismo nivel de confiabilidad. Una falla temporal en un widget de recomendación opcional no tiene el mismo impacto que una falla en el procesamiento de pagos o en la funcionalidad de emergencia.
Los requisitos de fiabilidad deben identificar los recorridos críticos, la interrupción aceptable y la experiencia de recuperación. Esos requisitos influyen en qué medidas técnicas compensan su coste.
Dependencias
El software rara vez existe de forma aislada. Una característica puede depender de otro servicio interno, una API, una base de datos, un proveedor externo o una infraestructura propiedad de otro equipo. Por ejemplo:
Pagar → Servicio de pedido → Proveedor de pago
Si el proveedor de pago no está disponible, el pago puede fallar incluso aunque sus propios sistemas estén funcionando correctamente. Las dependencias son importantes porque afectan la confiabilidad, la propiedad y la planificación de la entrega. Una función que requiere que otro equipo cambie su servicio puede tener un cronograma diferente al que su equipo controla por completo. Una dependencia externa también puede introducir riesgos que su organización no puede solucionar directamente.
Para cada dependencia conviene establecer quién es responsable, qué disponibilidad o tiempo de respuesta necesita el producto y qué ocurrirá si esa condición deja de cumplirse.
Deuda técnica
A medida que los productos evolucionan, los equipos a veces toman decisiones que optimizan la necesidad inmediata en lugar de la solución ideal a largo plazo. Con el tiempo, esas decisiones pueden acumularse en lo que comúnmente se llama deuda técnica.
La deuda técnica no significa necesariamente que la decisión original fuera mala. Un equipo puede elegir deliberadamente una solución más rápida o más sencilla porque llevar algo al mercado rápidamente es más valioso en ese momento. La desventaja es que los cambios futuros pueden volverse más difíciles o costosos.
Imagínese un sistema creado rápidamente para respaldar un mercado. Años más tarde, la empresa quiere respaldar diez mercados, múltiples monedas y varios modelos de precios. Es posible que la arquitectura original aún funcione, pero ampliarla ahora podría requerir un esfuerzo considerablemente mayor.
Desde la perspectiva de la gestión de productos, lo importante es comprender las consecuencias. La deuda técnica puede afectar la velocidad de entrega, la confiabilidad, el esfuerzo de ingeniería y el costo de futuras decisiones sobre productos.
Refactorización
Refactorizar significa mejorar la estructura interna del software sin cambiar necesariamente lo que los usuarios pueden hacer. Esto puede dificultar la priorización del trabajo desde la perspectiva del Producto porque es posible que el resultado no sea visible para los clientes. La interfaz tiene el mismo aspecto antes y después, pero Ingeniería puede dedicar mucho tiempo a ella.
El valor suele estar en lo que se vuelve más fácil después. Una refactorización podría reducir la complejidad, hacer que el sistema sea más seguro de modificar, mejorar la mantenibilidad o eliminar restricciones que están ralentizando el desarrollo futuro.
Una propuesta de refactorización debe relacionarse con una limitación concreta: cambios lentos, fallos repetidos o una parte del sistema difícil de probar. Conviene comparar el coste de la intervención con el trabajo o el riesgo que pretende reducir y acordar cómo se evaluará el resultado.
Sistemas heredados
La palabra heredado se utiliza a menudo para describir sistemas más antiguos, pero la edad por sí sola no indica si el software es un problema. Un sistema construido hace diez años puede ser estable, fácil de mantener y perfectamente adaptado a su propósito. Un sistema creado hace seis meses ya puede resultar difícil de cambiar.
Lo que importa es si el sistema aún respalda las necesidades del producto y la organización. Los problemas pueden aparecer cuando la tecnología ya no es compatible, el conocimiento ha desaparecido del equipo, los cambios se han vuelto inusualmente riesgosos o la arquitectura original ya no se adapta a la forma en que se utiliza el producto.
Reemplazar un sistema heredado también puede ser costoso y riesgoso, particularmente cuando admite procesos comerciales críticos. Es por eso que “reescribirlo” rara vez es una decisión tan simple como parece.
Un sistema heredado se evalúa por sus limitaciones actuales: cambios lentos, dependencias sin soporte, incidentes recurrentes o costes operativos. Su antigüedad aporta poca información sobre si está justificado sustituirlo.
¿Por qué una característica simple puede ser técnicamente difícil?
Una de las fuentes más comunes de fricción entre Producto e Ingeniería es una característica que parece pequeña desde fuera pero que recibe una estimación sorprendentemente grande. Imagínese agregar una pequeña información a una pantalla existente. El cambio de la interfaz de usuario en sí puede llevar muy poco tiempo, pero quizás esa información no esté almacenada actualmente. O existe en otro servicio. Tal vez una nueva API necesite exponerlo, agregar permisos y las versiones móviles más antiguas aún deben seguir siendo compatibles.
Cómo se veía:
Agregar un campo a la pantalla
en realidad puede implicar:
Frontend → API → Backend → Base de datos → Permisos → Pruebas
Es por eso que la complejidad visual y la complejidad técnica no son lo mismo. Un pequeño cambio en la interfaz puede cruzar varios límites arquitectónicos, mientras que un cambio visualmente sustancial puede ser relativamente fácil si ya existen todos los datos y capacidades necesarios.
La estimación debe contemplar todos esos cambios, incluida la compatibilidad y las pruebas. Una maqueta de pantalla deja sin concretar buena parte de ese trabajo.
Preguntas que los Product Managers deberían hacer sobre arquitectura
Una funcionalidad que atraviesa los límites de varios sistemas necesita una revisión explícita de los componentes y equipos implicados. Empiece por comprender qué componentes están involucrados. ¿El cambio afecta sólo al frontend o también están involucrados servicios backend, bases de datos o sistemas externos? Luego observe las dependencias y la propiedad. ¿Necesita otro equipo hacer un cambio? ¿Confiamos en un proveedor externo?
Los datos son otra área útil para investigar. ¿De dónde proviene la información, dónde se almacena y el producto ya tiene acceso a todo lo que requiere la función? Para viajes críticos, también vale la pena hablar sobre fallas y confiabilidad. ¿Qué sucede si uno de los componentes no está disponible? ¿Falla todo el recorrido o el producto puede degradarse con gracia? ¿Existen consideraciones de rendimiento o escalabilidad si el uso aumenta?
Finalmente, cuando Ingeniería proponga un cambio arquitectónico más sustancial, pregunte acerca de las compensaciones. ¿Qué problema soluciona el cambio? ¿Qué pasa si no lo hacemos ahora? ¿Reduce un riesgo actual, permite el trabajo futuro o mejora la capacidad del equipo para realizar cambios de forma segura?
Estas preguntas le permiten comprender las consecuencias del producto de una decisión arquitectónica sin intentar tomar la decisión técnica usted mismo.
¿Los Product Managers necesitan comprender la arquitectura del software?
Ingeniería se ocupa del diseño detallado del sistema. Producto aporta requisitos sobre recorridos de cliente, carga prevista, fallos aceptables y cambios que prevé el negocio. Lo que es útil es tener un modelo mental de los componentes principales: frontend, backend, bases de datos, API, servicios, dependencias, comunicación sincrónica y asincrónica, escalabilidad, confiabilidad y deuda técnica.
Con esa base, las conversaciones de ingeniería se vuelven mucho más fáciles de interpretar. Cuando alguien explica que una característica cruza varios servicios, depende de una API externa o requiere cambios en un componente heredado, tienes suficiente contexto para entender por qué eso es importante en términos de alcance, riesgo y entrega.
Profundización: arquitectura de software para directores de producto
El libro Arquitectura de Software para Product Managers desarrolla estos conceptos a través del frontend, el backend, las bases de datos, los servicios y las restricciones que afectan a los cambios de producto.
Continuar aprendiendo Gestión Técnica de Productos
La arquitectura del software se vuelve aún más útil cuando la conecta con otros conceptos técnicos que encuentran los Product Managers. Las API explican cuántos de estos componentes se comunican, SQL y los datos le ayudan a comprender la información que almacenan, la observabilidad le muestra lo que sucede cuando esos sistemas se ejecutan en producción y CI/CD explica cómo los cambios se mueven a través de ellos hasta que llegan a los usuarios.
La ruta de aprendizaje de Technical Product Management conecta estos temas con otras decisiones técnicas del trabajo de producto.
Explore el libro → Arquitectura de software para Product Managers
Un cambio pequeño en pantalla con tres dependencias
Escenario ilustrativo: una tienda quiere mostrar la fecha estimada de entrega antes del pago. El diseño añade una línea al checkout, pero la fecha depende del stock, la preparación del almacén y el transportista. La pregunta de arquitectura es dónde se calcula esa promesa y qué sistemas necesitan ponerse de acuerdo.
Antes de estimar el trabajo, dibuja la decisión con Ingeniería:
- Fuente de verdad: ¿qué sistema controla el stock y cuál la estimación de entrega?
- Actualización: ¿sirve la información de ayer o debe reflejar una reserva hecha hace segundos?
- Fallo: ¿qué mostrará el checkout si el transportista no responde?
- Alcance: ¿puede la primera versión mostrar un intervalo para un transportista, en lugar de una fecha exacta para cada pedido?
Una primera versión podría mostrar un intervalo de entrega para una región, con un mensaje claro cuando no haya estimación. Eso reduce la promesa que hace el producto; no elimina la necesidad de acordar cómo se gestionan el stock y la información de entrega.
Decisión que te llevas: documenta la promesa al cliente, los sistemas implicados y el comportamiento ante fallos antes de considerar pequeño un cambio de pantalla. La arquitectura adecuada depende de esos requisitos, no solo del número de componentes.
Para profundizar en la base técnica, consulta los principios de diseño de aplicaciones de Microsoft. Para organizar la lectura, utiliza nuestra guía para elegir un libro técnico.
El centro de aprendizaje de Gestión técnica de productos también cubre API, SQL y datos, métricas de productos, registros y observabilidad, seguridad y CI/CD y versiones.
Explore el Centro de aprendizaje sobre gestión técnica de productos
Para seguir un recorrido concreto de pedido y pago, consulta Cómo leer un diagrama de arquitectura de software como Product Manager, con un checkout anotado y preguntas sobre sus dependencias.